Agent 动手之前,先让它交证据:阿里开源 OpenGuardrail
Agent 一旦接过工具,删除、发布、改配置就不再是“说一说”,而是真的落在地上。问题是:谁来证明这一步应该被放行?阿里刚开源的 OpenGuardrail,把这件事做成了一份可以核验、也可以追溯的记录。
一、Agent 开始“动手”,风险换了个量级
过去我们用 AI,最坏的结果是它写错一段话,你重写一遍就行。
现在不一样了。Agent 接上文件系统、CI、云控制台之后,删一个目录、发一次版本、改一项配置,都是一次就真的落地的操作。
于是 prompt 里开始出现这类话:“删除前先确认”“发布前先跑测试”“改配置前先看影响范围”。
这些话有用,但有个绕不过去的坎:说过,不等于做过;做过,也不等于留下了证据。
当执行工具要在按下按钮前判断“这一步能不能干”,它需要的不是 Agent 的自述,是一份能核对的依据。
二、三个断点:检查、放行、追溯
把“Agent 操作真实系统”这件事拆开,其实只有三个问题:
- 检查在哪儿做:要查哪些项,查到什么程度算过关?
- 凭什么放行:工具收到一句“我查过了”,敢不敢信?
- 事后怎么追溯:三天后出了问题,拿什么还原当时的判断?
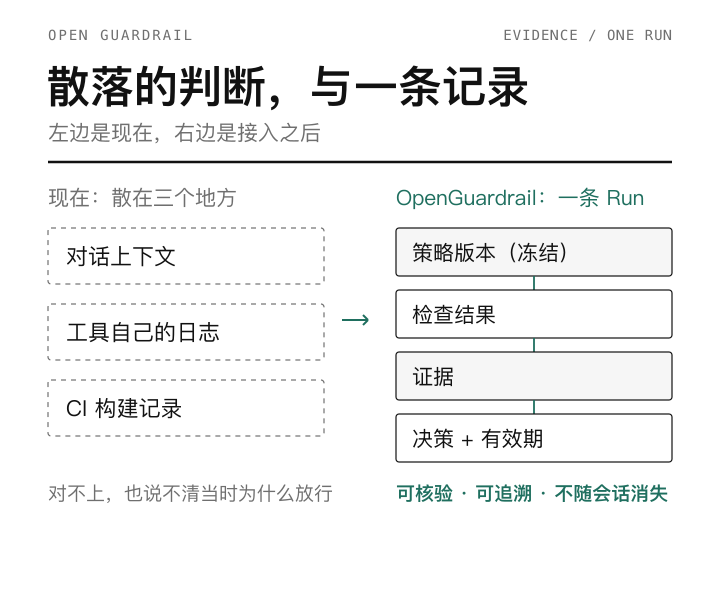
现在这三件事,大多散在三个地方:对话上下文里、工具自己的日志里、CI 的构建记录里。真出事,得靠人把几份日志对在一起,还不一定对得上。
OpenGuardrail 要解决的就是这个“对不上”。
三、它的做法:把一次放行拆成五步
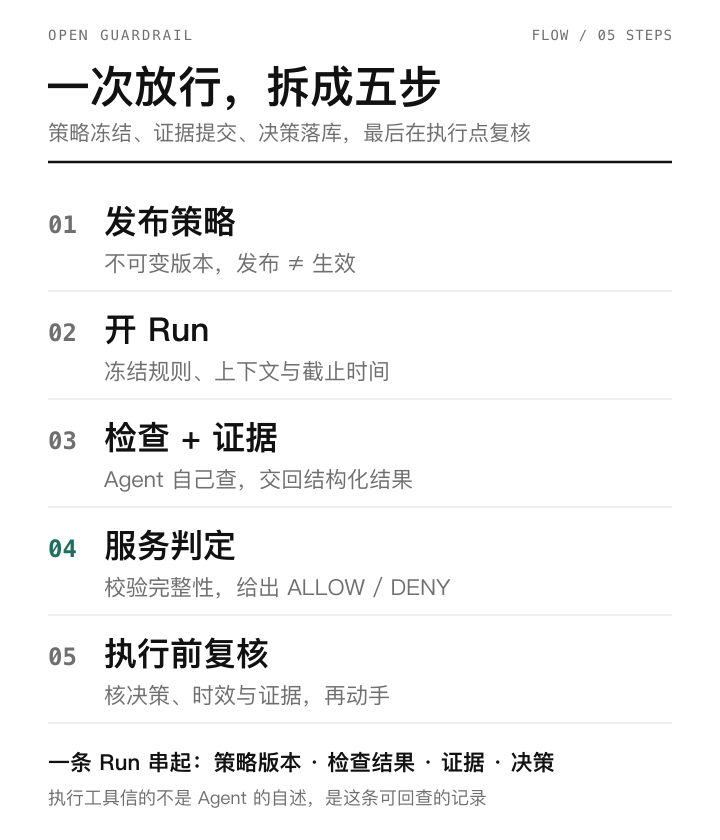
先做的第一件事,是发布一份策略。
每个业务动作定义自己的必查项:发布要测试通过、目标分支匹配;改配置要范围合规、审批已经记录;删数据要对象和影响面都在允许范围内。
策略发布后是不可变的版本,而且发布和生效还是两件事——这点很像代码上线,改完不等于立刻作用于线上。
接着开一个 Run。
Run 是一次独立评估。它会把当前策略版本、调用方给的上下文、截止时间一起冻结下来。后面所有检查都对着这一版规则做,不会中途换标准。
第三步最反直觉:检查由 Agent 自己去做,服务不代劳。
注意,检查不在服务里做。Agent 读 Run 里的要求,去查真实状态,再把检查结果和证据(什么时间、查了什么、结果是什么、引用在哪)提交回来。中间可以交快照,最后交一次完整结果。
Agent 交完之后,才轮到服务做判定。
服务不自己去摸文件系统。它做的是核对:这份提交对不对得上冻结的策略、证据齐不齐、几项检查聚合起来是什么结果。然后把决策和有效期一起存下来。
最后一关在执行工具那一端:先复核,再动手。
真正删文件、发版本的那一端,拿到的不是一句“通过了”,而是一个可回查的 Run:决策是不是当前有效、策略版本对不对、证据是不是这一批、要动的对象和当时检查的是不是同一个。
五步走完,一次操作就有了完整的“为什么放行”。
四、最见功力的一条:查不清,就当不行
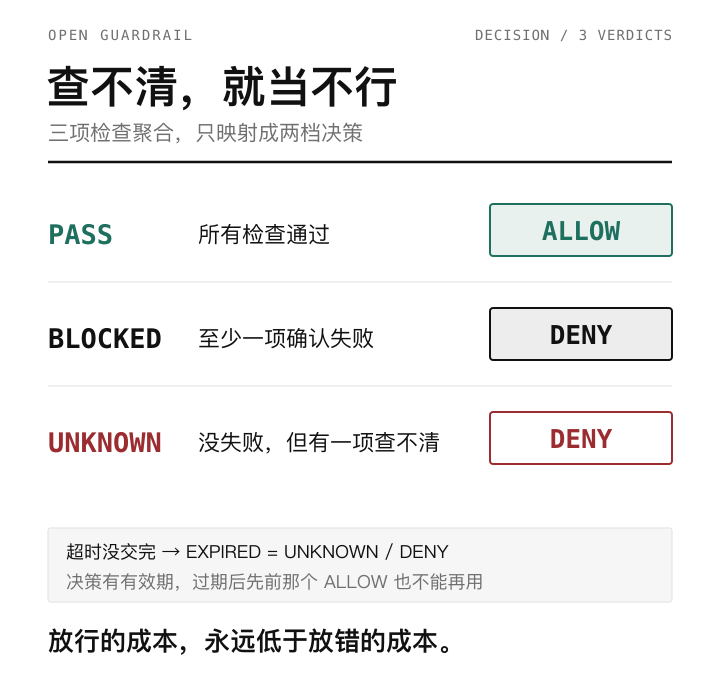
三项检查聚合下来,只有三种结果:
- PASS:所有检查通过 → ALLOW
- BLOCKED:至少一项确认失败 → DENY
- UNKNOWN:没有一项失败,但至少一项查不清 → 还是 DENY
第三条是整套设计里最值得抄的一点。
Agent 干活,“我没查到”比“我查到没问题”常见得多:接口超时、权限不够、对象刚被改过。不少系统会把这种状态当成“没报错”放过去。
OpenGuardrail 的选择是不确定就不放行。
再加两道保险:
- Run 有截止时间,过期没交完,直接算 UNKNOWN / DENY;
- 决策有有效期,过了这个窗口,先前那个 ALLOW 也不能再用。
一句话:放行的成本,永远低于放错的成本。
五、一个 demo:四个文件,先被拒,再被放行
仓库里有个本地 demo,不需要模型账号、不需要 Docker、也不需要 Jenkins。
跑起来就是一次真实的文件清理:第一次请求选了四个文件,两个临时文件、一个订单文件、一个配置文件。Agent 把看到的文件状态交上去,结果是 BLOCKED / DENY——订单和配置不在允许范围内。
然后它收窄请求,只留两个临时文件,重开一个 Run。这次是 PASS / ALLOW。执行工具回读这个 Run 和里面的证据,确认文件没有被换过,才删掉那两个 .tmp。订单和配置原样留在磁盘上。
最有意思的是后台:你能展开看到这次 Run 冻结的策略原文、提交上来的证据、最终决策,以及上一次被拒的记录。拒绝没有被覆盖,它就在历史里。
这个 demo 的说服力在于:它不是演示一个概念,而是真的在一个临时目录里删了文件。
六、收益:不是多一层审批,是把依据留下来
如果只看“多了一道检查”,很容易觉得这是给 Agent 加审批流。它真正改变的是三件事:
- 对 Agent 开发者:不用把审计逻辑写进每一个工具。检查怎么做、证据怎么交,按同一套接口来。
- 对执行工具:终于有一个可验证的输入。它信的不是 Agent 的“我查过了”,而是服务里那条带有效期、带证据的决策。
- 对审计的人:一次 Run 把策略版本、检查结果、证据、决策串成一条线。事后不用再猜当时为什么放行。
再往上一层,它用的是 Scene 模型:一个场景一组策略,共用同一套证据与决策结构。所以新增业务不用改核心 API,只要写新场景的策略。
目前仓库里能跑的有 Jenkins、Argo Rollouts 的交付流程示例;pi / DeepSeek Harness 的插件还是内部预览;本地清理 demo 和 Recovery Agent demo 可以直接上手。
七、也说清楚边界
项目自己写得很克制,这几点值得提前知道:
- 检查在服务外执行,服务只校验结构与完整性,不独立验证观测是不是真的。证据真伪,最终要由调用方自己核。
- 决策的应用、动作的控制,归调用方。Execution Claims 和 ActionResults 还在计划里。
- 目前是单实例部署,API 是
v1alpha1,preview 阶段契约还可能变。
这不是缺点清单,是边界说明。它解决的是“记录与核验”,不是“替你把关”。把这个边界看清楚,反而更容易判断它适不适合你。
八、什么样的团队值得试
我的判断是三类:
- 已经让 Agent 碰生产环境的:哪怕只是“删临时文件”“清理测试数据”,也该有一条可回查的放行记录。
- 正在做 Agent 平台或工具市场的:与其让每个工具自己写一套审计,不如统一到一个决策接口。
- 做 AI 交付流水线的:Jenkins / Argo 的例子已经给到位,接进去的成本可控。
上手很轻:git clone 之后跑 python3 examples/cleanup-demo/demo.py,不需要模型账号。先看它拒一次、再放一次,你就明白这套东西的价值观了。
Agent 的能力上限,不取决于它能做多少事,而取决于你敢让它做多少事。而“敢”,来自可核验的证据。 —— 风哥玩AI
最后
项目是 Apache-2.0,地址:github.com/alibaba/open-guardrail
如果你也在做 Agent 和自动化,去跑一遍那个清理 demo,比看十页文档快。觉得方向有价值,点个 Star;有想法,欢迎提 PR。
护栏这件事,越多人一起定标准,后面越省事。